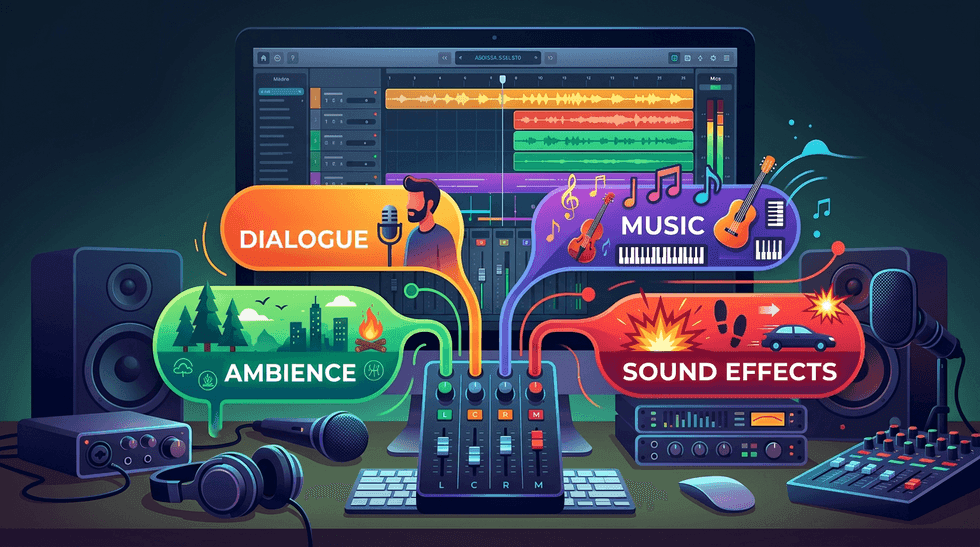
Adobe testează în beta-ul Premiere Pro funcția Enhance Audio, un instrument generativ care descompune o înregistrare în componente distincte pentru a permite reechilibrarea sunetului în timpul montajului, potrivit No Film School. Unitatea de procesare separă clipul în vorbire, muzică, ambianță, efecte sonore și reverberație și oferă controale individuale pentru fiecare strat. Editorul poate ridica dialogul independent, reduce sau muta complet un fundal muzical lăsat pe platou sau plasa ambianța sub voce, observând modificarea în waveform în timp real.
Separarea pornește de la ideea că o înregistrare problematică nu prezintă o singură problemă, ci mai multe suprapuse. În versiunile anterioare de instrumente similare, reducerea zgomotului subția dialogul, iar accentuarea vocii aducea cu sine și ecoul camerei. Enhance Audio încearcă să izoleze straturile astfel încât ajustările să nu fie un compromis între elemente.
Dialogul primește cele mai multe opțiuni. Utilizatorul alege gradul de curățare, de la înregistrarea originală până la tratamentul complet, iar un control dedicat de reverberație permite îndepărtarea parțială a camerei din voce. Efectul depinde de material: înregistrările foarte reverberante se schimbă vizibil, cele „uscate” aproape deloc, de aceea articolul recomandă o ascultare atentă în loc de presupuneri.
Din punct de vedere al fluxului de lucru, instrumentul păstrează editarea continuă. Spre deosebire de versiunile anterioare ale Enhance Speech, unde fiecare tăiere, fade sau ajustare declanșa o nouă randare, acum montajul rămâne fluid. Premiere procesează cinci secunde de handle pe fiecare parte a clipului, astfel încât extinderea editului în interiorul acestora nu necesită re-procesare, iar depășirea lor analizează doar porțiunea nouă.
Există două variante de model. Enhance Speech V1 rulează local, nu consumă credite și oferă separarea completă. V2, modelul vocal de cea mai bună calitate al Adobe, rulează în cloud prin Firefly și consumă două credite generative pe minut din pachetul inclus în abonamentul Creative Cloud. Cele două pot fi comutate clip cu clip, fiind descrise ca o trecere rapidă versus una optimă.
Instrumentul nu finalizează mixul. După procesare se recomandă ascultarea dialogului izolat și apoi în context cu restul elementelor, reducerea curățării dacă vocea începe să sune procesată, verificarea așezării muzicii și ambianței și evitarea conflictelor prin ducking sub vorbire. Testarea pe mai multe difuzoare înainte de export este prezentată ca modalitate de a păstra curățarea invizibilă pentru spectator.
Pentru editori, câștigul este posibilitatea de a păstra o luare pe care altfel ar fi fost nevoie să o ocolească. Decizia poate fi luată în interiorul Premiere, ca parte a editării, fără așteptarea unei randări suplimentare. Soluția nu transformă o înregistrare proastă într-una bună, dar oferă mai mult material de lucru înainte de a renunța la un clip, iar beta-ul este disponibil prin descărcările Creative Cloud.